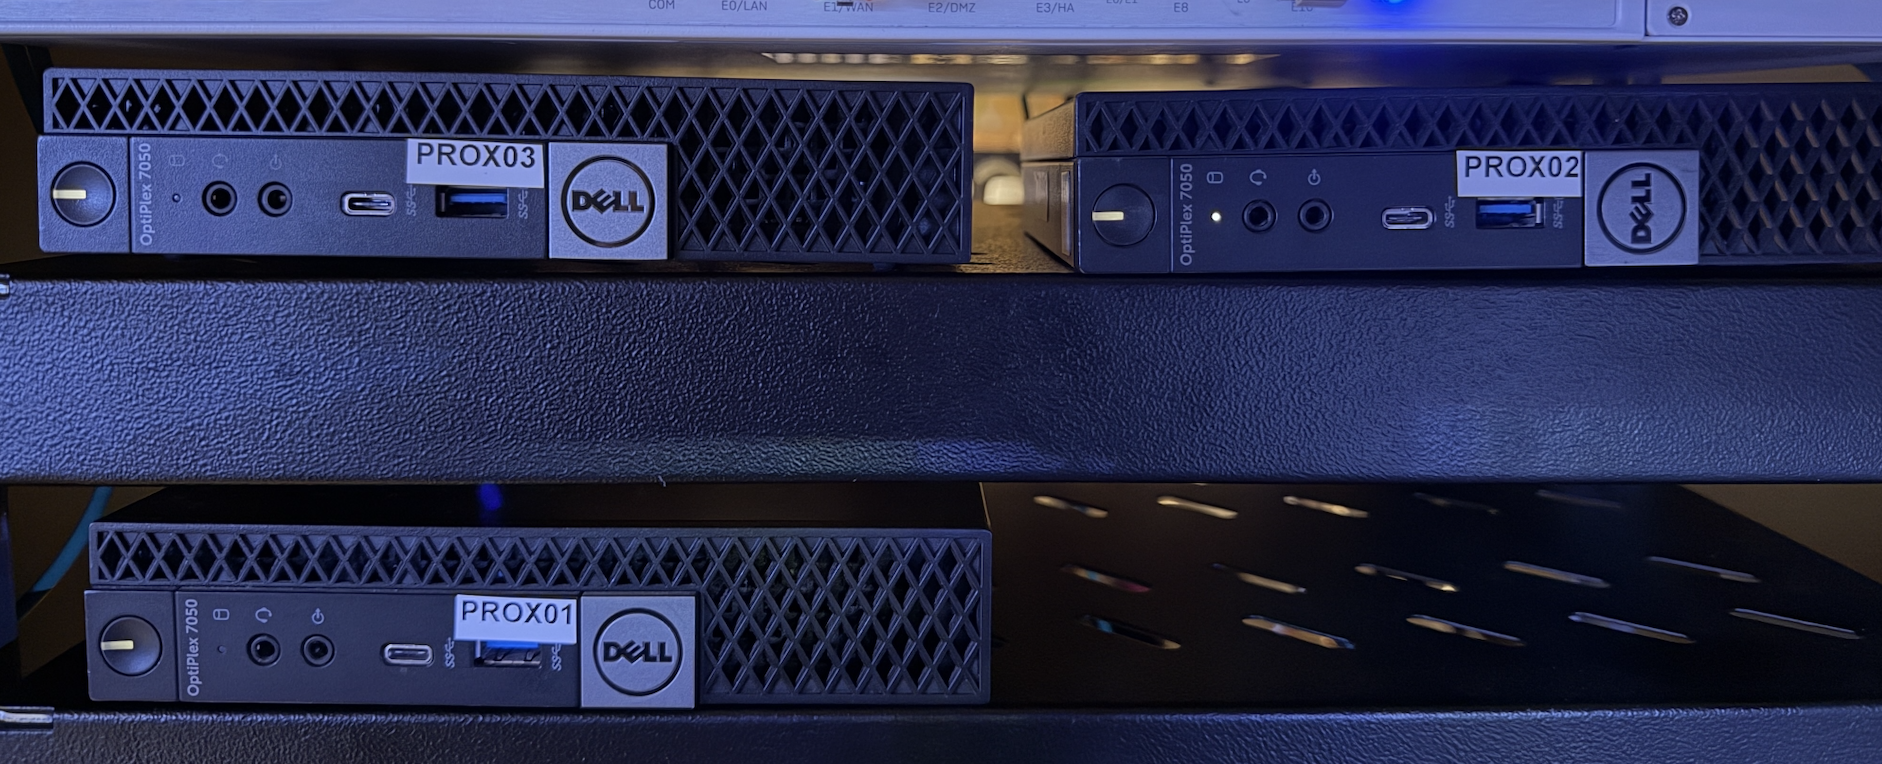
Ende September habe ich mein Proxmox-Labor umgebaut: in prox01 und prox02 kamen neue CPUs, und dazu ist als dritter Knoten ein weiterer Optiplex 7050 gewandert. Damit habe ich zum ersten Mal ein echtes Cluster mit Quorum statt zwei Knoten, die sich gegenseitig anschauen. Beim Aufräumen danach ist mir aufgefallen, dass der wichtigste Teil dieses Clusters an einem einzigen Netzwerkkabel pro Knoten hängt — und das möchte ich in diesem Beitrag ändern.
Es geht um Corosync. Das ist die Komponente, die aus drei einzelnen Servern überhaupt erst ein Cluster macht, und sie ist gleichzeitig die empfindlichste im ganzen Aufbau. Wer schon einmal erlebt hat, wie ein Proxmox-Cluster seine Konfiguration auf einmal nur noch lesend anfasst, hat Corosync bei der Arbeit gesehen.
Was Corosync eigentlich tut
Proxmox legt seine Cluster-Konfiguration nicht in einer Datenbank ab, sondern in
einem eigenen Dateisystem: /etc/pve ist kein normales Verzeichnis, sondern
pmxcfs, ein replizierter Speicher, den alle Knoten identisch sehen. Wenn ihr auf
prox01 eine VM anlegt, liegt deren Konfigurationsdatei eine Sekunde später auch
auf prox02 und prox03.
Damit das funktioniert, müssen sich die Knoten permanent einig sein, wer
überhaupt dazugehört. Genau das ist Corosyncs Aufgabe. Es verschickt dazu über
das Totem-Protokoll sehr kleine Pakete in sehr kurzen Abständen und stellt
darüber fest, welche Knoten noch antworten. Fallen zu viele aus, ist die
Mehrheit weg — und ohne Mehrheit gibt es kein Quorum. Ein Knoten ohne Quorum
macht /etc/pve schreibgeschützt. Das ist kein Fehler, sondern Absicht: lieber
nichts ändern können, als eine Änderung zu machen, von der die anderen Knoten
nichts wissen. Wer HA-Ressourcen konfiguriert hat, erlebt zusätzlich, dass sich
ein Knoten ohne Quorum nach einer Weile selbst neu startet, damit seine VMs
gefahrlos woanders anlaufen können.
Und jetzt der Punkt, der die ganze Sache heikel macht: Corosync interessiert sich nicht für Bandbreite, sondern für Laufzeit und Gleichmäßigkeit. Ein Gigabit-Link, auf dem gerade ein Backup läuft, hat massig Durchsatz und trotzdem Latenzspitzen von einigen hundert Millisekunden. Für einen Dateitransfer ist das egal. Für Corosync ist es der Unterschied zwischen „alles in Ordnung“ und „der Knoten ist weg“.
Deshalb lautet die Empfehlung seit Jahren: Corosync gehört auf ein Netz, auf dem sonst nichts Großes passiert. Genau das habe ich im Labor auch gemacht — und mir damit ein anderes Problem eingebaut.
Die Ausgangslage in meinem Labor
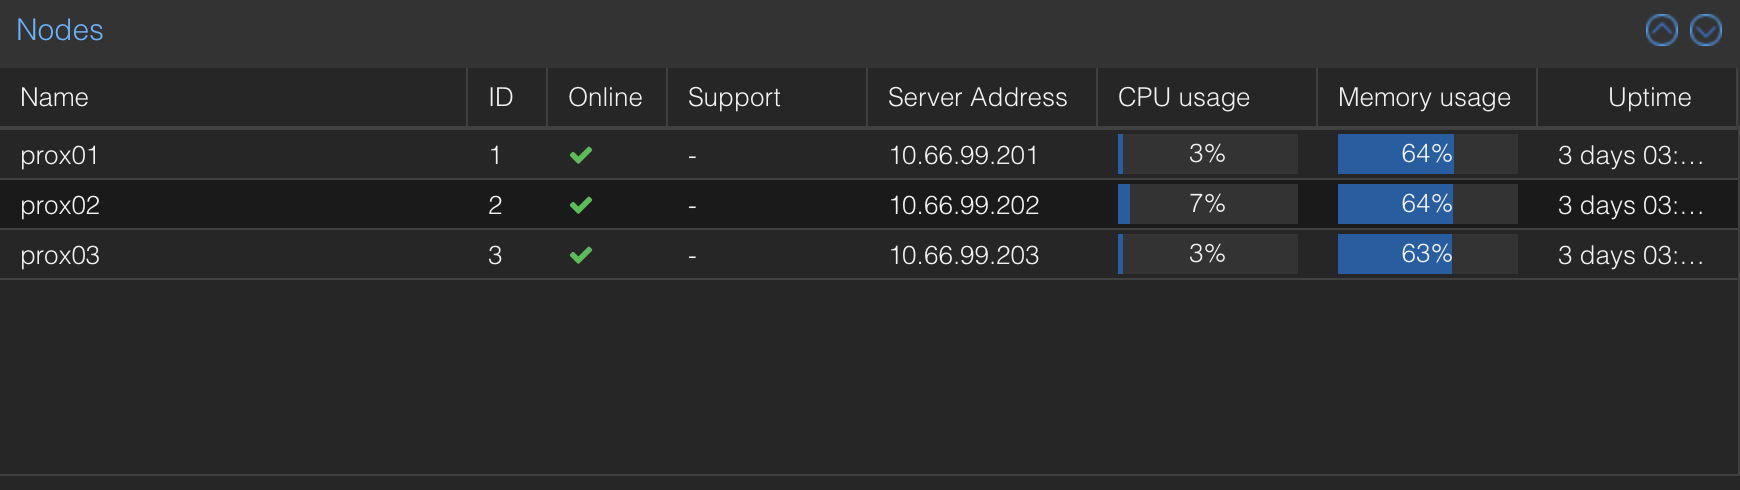 Drei Knoten, ein Cluster — seit dem Umbau Ende September.
Jeder der drei Optiplex hat zwei Netzwerkanschlüsse: die Onboard-NIC und eine zweite Karte. Aufgeteilt ist es so:
| Netz | Interface | Wofür |
|---|---|---|
10.66.99.0/24 | enp0s31f6 in der Bridge vmbr0 | Management, VM-Verkehr, Backups |
10.10.10.0/24 | zweite NIC, ohne Bridge | nur Cluster-Kommunikation |
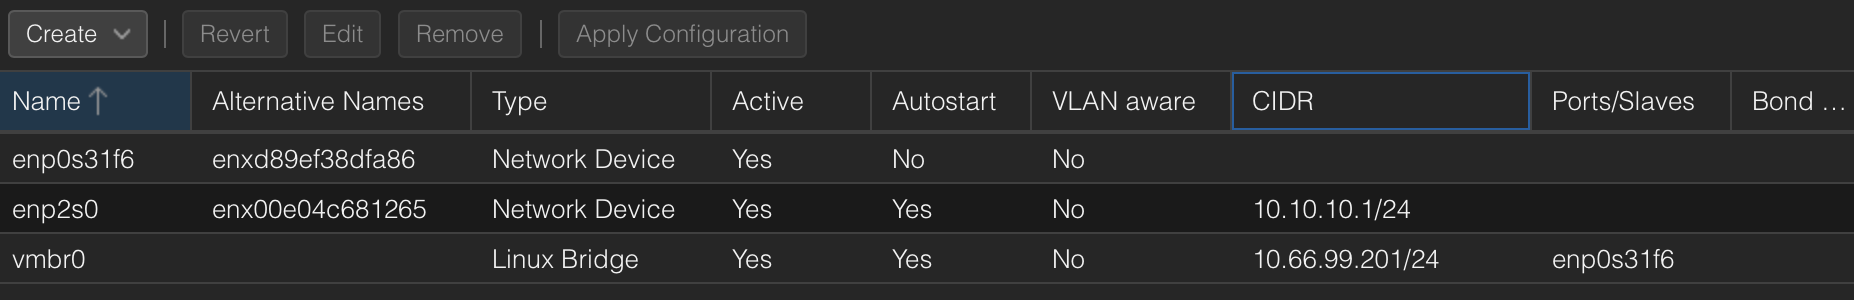 Die Netzwerkkonfiguration eines Knotens:
vmbr0 mit der Onboard-Karte fürs
Management, daneben die zweite Karte allein fürs Cluster-Netz.
Corosync läuft also auf dem separaten Netz 10.10.10.0/24, prox01 hat dort
.1, prox02 die .2 und prox03 die .3. Nachsehen kann man das mit:
pvecm status
Cluster information
-------------------
Name:             prox-cl01
Config Version:   3
Transport:        knet
Secure auth:      on

Quorum information
------------------
Date:             Wed Sep 30 12:53:21 2026
Quorum provider:  corosync_votequorum
Nodes:            3
Node ID:          0x00000001
Ring ID:          1.b2
Quorate:          Yes

Votequorum information
----------------------
Expected votes:   3
Highest expected: 3
Total votes:      3
Quorum:           2
Flags:            Quorate

Membership information
----------------------
    Nodeid      Votes Name
0x00000001          1 10.10.10.1 (local)
0x00000002          1 10.10.10.2
0x00000003          1 10.10.10.3
Interessant ist die Zeile mit den Links am Ende der Ausgabe, und noch genauer wird es hiermit:
corosync-cfgtool -s
Local node ID 1, transport knet
LINK ID 0 udp
	addr	= 10.10.10.1
	status:
		nodeid:          1:	localhost
		nodeid:          2:	connected
		nodeid:          3:	connected
Bei mir stand dort genau ein Eintrag: LINK ID 0. Und das ist die Schwachstelle.
Das dedizierte Cluster-Netz ist fürs Timing wunderbar — aber es ist eben nur
ein Pfad. Geht der Switch aus, an dem diese drei Karten hängen, oder rutscht
auf einem Knoten ein Kabel heraus, verliert das Cluster sein Quorum. Dass jeder
Knoten über vmbr0 weiterhin bestens erreichbar ist und die VMs munter
weiterlaufen, hilft dann nichts: Corosync schaut dort nicht hin.
Corosync 3 kann genau dafür mehrere Links verwalten, bis zu acht. Und mein zweiter Pfad liegt eigentlich schon fertig da — das Management-Netz.
Was ein zweiter Ring bringt, und was nicht
Kurz die Erwartungen sortieren, sonst baut man das Falsche:
Ein zweiter Ring ist Ausfallsicherheit, keine Leistungssteigerung. Corosync
bündelt die Links nicht, es verteilt die Last nicht. Standardmäßig steht
link_mode: passive, das heißt: es wird genau ein Link benutzt, und wenn der
Probleme macht, wird auf den nächsten umgeschaltet. Es gibt auch
link_mode: active, bei dem über alle Links gleichzeitig gesendet wird — das
schaltet schneller um, kostet aber mehr CPU und erzeugt mehr Verkehr. Für ein
Labor und für die meisten produktiven Cluster ist passive richtig.
Der zweite Ring muss ein anderer physikalischer Weg sein. Zwei IP-Adressen auf derselben Karte sind kein zweiter Ring, sondern ein zweiter Eintrag in einer Konfigurationsdatei. Wenn die Karte, das Kabel oder der Switchport ausfällt, fallen beide weg. Das klingt selbstverständlich, ist aber der häufigste Fehler bei dieser Übung — und der gefährlichste, weil das Ergebnis aussieht wie Redundanz.
Die Reihenfolge ist eine Aussage, keine Kosmetik. Link 0 ist der bevorzugte
Pfad. Auf meinen soll also weiterhin das ruhige 10.10.10.0/24 liegen, und das
Management-Netz wird Link 1 — der Ersatzweg, der zum Zug kommt, wenn der gute
Pfad wegbricht. Umgekehrt wäre es unklug: dann läuft der Normalbetrieb dauerhaft
über dasselbe Netz, auf dem auch die Backups liegen.
Als Bild sieht der Plan so aus:
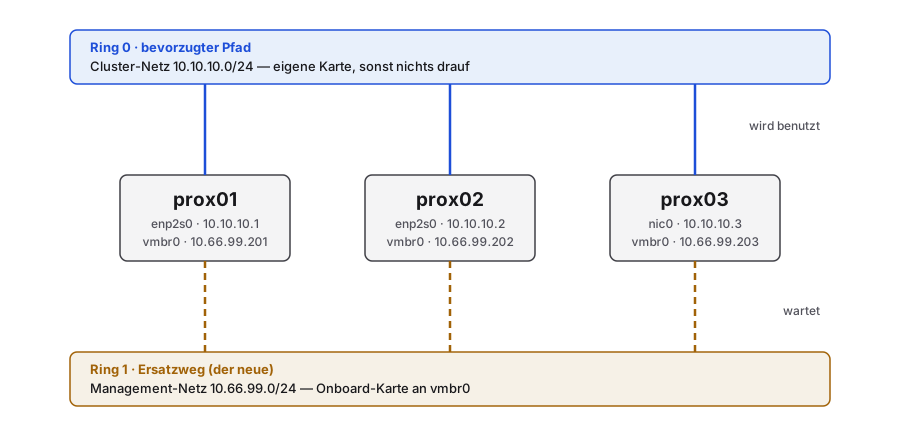 Zwei Wege, zwei Karten, zwei Switches. Solange der obere steht, wird der untere
nicht benutzt — er muss nur da sein.
Am Rande noch eine Beobachtung aus meinem Aufbau, die beim Konfigurieren
Nerven kostet, wenn man sie nicht kennt: die zweite Karte heißt auf prox01 und
prox02 enp2s0, auf prox03 aber nic0. Für Corosync ist das komplett
irrelevant, weil in der Konfiguration IP-Adressen stehen und keine
Interfacenamen. Beim Einrichten der Netze auf dem Knoten muss man aber genau
hinsehen.
Vorher: Netz vorbereiten und einen Rückweg sichern
Bevor irgendetwas an Corosync geändert wird, muss der zweite Weg tatsächlich funktionieren. Prüft von jedem Knoten aus, dass er die beiden anderen über das künftige Ring-1-Netz erreicht:
ping -c 100 -i 0.2 10.66.99.202
ping -c 100 -i 0.2 10.66.99.203
Worauf ich dabei schaue, ist nicht der Mittelwert, sondern die Ausreißer und
mdev am Ende der Zusammenfassung. Bei mir sah es über alle sechs Pfade so aus —
je 60 Pakete, zum Vergleich auch über das bestehende Cluster-Netz:
| von → nach | Verlust | min/avg/max/mdev in ms |
|---|---|---|
| prox01 → prox02, Management | 0 % | 0,133 / 0,347 / 0,543 / 0,080 |
| prox01 → prox03, Management | 0 % | 0,189 / 0,377 / 0,563 / 0,100 |
| prox02 → prox03, Management | 0 % | 0,141 / 0,347 / 0,491 / 0,077 |
| prox01 → prox02, Cluster-Netz | 0 % | 0,071 / 0,254 / 0,443 / 0,095 |
| prox01 → prox03, Cluster-Netz | 0 % | 0,051 / 0,319 / 0,486 / 0,103 |
| prox02 → prox03, Cluster-Netz | 0 % | 0,082 / 0,283 / 0,467 / 0,104 |
Kein Paketverlust, alles weit unter einer Millisekunde. Das Management-Netz ist durchgehend ein wenig langsamer als das dedizierte Cluster-Netz — nicht dramatisch, aber es bestätigt die Rollenverteilung: das ruhige Netz bleibt Link 0.
Dann eine Sicherung anlegen. Die kostet nichts und ist der Unterschied zwischen einer ruhigen und einer sehr unruhigen Stunde:
cp /etc/pve/corosync.conf /root/corosync.conf.$(date +%F)
Und abschließend die Lage prüfen: alle Knoten online, Cluster quorat, kein HA-Vorgang und kein Backup unterwegs.
pvecm status
ha-manager status
Die Änderung
Bearbeitet wird /etc/pve/corosync.conf — die Datei im replizierten
Dateisystem, nicht /etc/corosync/corosync.conf. Das ist wichtig: die Datei
unter /etc/pve wird auf alle Knoten verteilt, und Corosync lädt die Änderung
von selbst nach. Die Datei unter /etc/corosync ist die Kopie, die der Dienst
beim Start liest; dort editiert man nur im Notfall, dazu unten mehr.
Zwei Dinge sind zu tun. Erstens bekommt jeder Knoten in der nodelist neben
ring0_addr ein ring1_addr:
  node {
    name: prox01
    nodeid: 1
    quorum_votes: 1
    ring0_addr: 10.10.10.1
    ring1_addr: 10.66.99.201
  }
… und entsprechend prox02 mit 10.10.10.2 / 10.66.99.202 sowie prox03 mit
10.10.10.3 / 10.66.99.203.
Zweitens wird der neue Link im totem-Abschnitt bekannt gemacht, und — das ist
der Schritt, den man nicht vergessen darf — config_version wird um eins
erhöht:
totem {
  cluster_name: prox-cl01
  config_version: 4
  interface {
    linknumber: 0
  }
  interface {
    linknumber: 1
  }
  ip_version: ipv4-6
  link_mode: passive
  secauth: on
  version: 2
}
Unterm Strich sind es acht neue Zeilen und eine geänderte. So sieht die fertige Änderung gegen die Sicherung aus:
@@ -9,18 +9,21 @@
     nodeid: 1
     quorum_votes: 1
     ring0_addr: 10.10.10.1
+    ring1_addr: 10.66.99.201
   }
   node {
     name: prox02
     nodeid: 2
     quorum_votes: 1
     ring0_addr: 10.10.10.2
+    ring1_addr: 10.66.99.202
   }
   node {
     name: prox03
     nodeid: 3
     quorum_votes: 1
     ring0_addr: 10.10.10.3
+    ring1_addr: 10.66.99.203
   }
 }

@@ -30,10 +33,13 @@

 totem {
   cluster_name: prox-cl01
-  config_version: 3
+  config_version: 4
   interface {
     linknumber: 0
   }
+  interface {
+    linknumber: 1
+  }
   ip_version: ipv4-6
   link_mode: passive
   secauth: on
Bei mir stand vorher config_version: 3, also wird daraus die 4. Über diese
Zahl entscheiden die Knoten, welche Fassung der Konfiguration die neuere ist.
Vergisst man sie, verwerfen die anderen Knoten die Änderung — im besten Fall
passiert einfach nichts, im schlechteren habt ihr unterschiedliche
Konfigurationen mit gleicher Versionsnummer im Cluster.
Gespeichert wird einmal, auf einem Knoten. Den Rest macht pmxcfs.
Kontrolle
Jetzt die eigentliche Prüfung:
corosync-cfgtool -s
Erwartet werden nun zwei Blöcke, LINK ID 0 und LINK ID 1, und in beiden
für jeden der anderen Knoten der Status connected.
Local node ID 1, transport knet
LINK ID 0 udp
	addr	= 10.10.10.1
	status:
		nodeid:          1:	localhost
		nodeid:          2:	connected
		nodeid:          3:	connected
LINK ID 1 udp
	addr	= 10.66.99.201
	status:
		nodeid:          1:	localhost
		nodeid:          2:	connected
		nodeid:          3:	connected
Dazu ein Blick ins Protokoll, das bei dieser Aktion erstaunlich gesprächig ist:
journalctl -u corosync -n 50
Was ihr dort sehen wollt, ist das Nachladen der neuen Konfiguration und das Hinzufügen des neuen Links — und was ihr nicht sehen wollt, sind Meldungen über verlorene und wiedergefundene Mitgliedschaften. Wenn das Cluster bei dieser Änderung kurz die Mitgliedschaft neu bildet, ist meist die Versionsnummer oder eine der Adressen nicht korrekt.
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [CFG   ] Config reload requested by node 1
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [TOTEM ] Configuring link 0
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [TOTEM ] Configured link number 0: local addr: 10.10.10.1, port=5405
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [TOTEM ] Configuring link 1
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [TOTEM ] Configured link number 1: local addr: 10.66.99.201, port=5406
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [KNET  ] host: host: 2 (passive) best link: 0 (pri: 1)
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [KNET  ] host: host: 2 (passive) best link: 0 (pri: 1)
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [KNET  ] host: host: 2 (passive) best link: 0 (pri: 1)
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [KNET  ] host: host: 3 (passive) best link: 0 (pri: 1)
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [KNET  ] host: host: 3 (passive) best link: 0 (pri: 1)
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [KNET  ] host: host: 3 (passive) best link: 0 (pri: 1)
2026-09-30 12:53:57+02:00 prox01 corosync[27485]:   [KNET  ] pmtud: MTU manually set to: 0
2026-09-30 12:53:59+02:00 prox01 corosync[27485]:   [KNET  ] rx: host: 3 link: 1 is up
2026-09-30 12:53:59+02:00 prox01 corosync[27485]:   [KNET  ] link: Resetting MTU for link 1 because host 3 joined
2026-09-30 12:53:59+02:00 prox01 corosync[27485]:   [KNET  ] host: host: 3 (passive) best link: 0 (pri: 1)
2026-09-30 12:53:59+02:00 prox01 corosync[27485]:   [KNET  ] rx: host: 2 link: 1 is up
2026-09-30 12:53:59+02:00 prox01 corosync[27485]:   [KNET  ] link: Resetting MTU for link 1 because host 2 joined
2026-09-30 12:53:59+02:00 prox01 corosync[27485]:   [KNET  ] host: host: 2 (passive) best link: 0 (pri: 1)
2026-09-30 12:54:00+02:00 prox01 corosync[27485]:   [KNET  ] pmtud: PMTUD link change for host: 3 link: 1 from 469 to 1397
2026-09-30 12:54:00+02:00 prox01 corosync[27485]:   [KNET  ] pmtud: PMTUD link change for host: 2 link: 1 from 469 to 1397
2026-09-30 12:54:00+02:00 prox01 corosync[27485]:   [KNET  ] pmtud: Global data MTU changed to: 1397
Drei Dinge stehen da, die die Sache erklären. Config reload requested — es
wurde nichts neu gestartet, Corosync hat die Datei im Betrieb nachgeladen.
Configured link number 1: local addr: 10.66.99.201, port=5406 — der neue
Link bekommt einen eigenen UDP-Port, Link 0 bleibt auf 5405. Und
best link: 0 (pri: 1) — genau das, was link_mode: passive verspricht:
beide Links sind da, benutzt wird der erste.
Der Test, der es beweist
Alles bisher war Konfiguration. Ob sie etwas taugt, weiß man erst, wenn der bevorzugte Pfad wegbricht — und diesen Test würde ich nicht überspringen. Ich habe ihn auf prox03 gemacht, dem Knoten, auf dem am wenigsten liegt. Statt am Kabel zu ziehen, schalte ich die Karte ab; das ist dasselbe Ergebnis, lässt sich aber aus der Ferne machen und wieder einschalten:
ip link set nic0 down
Wichtig: Das ist die Karte des Cluster-Netzes. Meine Verbindung zum Knoten
läuft über vmbr0 und bleibt bestehen. Und damit ich mich nicht darauf verlassen
muss, die Karte hinterher auch wieder einzuschalten, habe ich das Abschalten mit
einem festen Zeitfenster versehen, das sie von selbst zurückholt:
setsid nohup bash -c "ip link set nic0 down; sleep 25; ip link set nic0 up" &
Während dieser 25 Sekunden sieht prox01 das:
Local node ID 1, transport knet
LINK ID 0 udp
	addr	= 10.10.10.1
	status:
		nodeid:          1:	localhost
		nodeid:          2:	connected
		nodeid:          3:	disconnected
LINK ID 1 udp
	addr	= 10.66.99.201
	status:
		nodeid:          1:	localhost
		nodeid:          2:	connected
		nodeid:          3:	connected
Link 0 zu Knoten 3 ist disconnected, Link 1 trägt. Und prox03 selbst, von innen
betrachtet — für ihn sind beide Nachbarn auf Link 0 weg:
Local node ID 3, transport knet
LINK ID 0 udp
	addr	= 10.10.10.3
	status:
		nodeid:          1:	disconnected
		nodeid:          2:	disconnected
		nodeid:          3:	localhost
LINK ID 1 udp
	addr	= 10.66.99.203
	status:
		nodeid:          1:	connected
		nodeid:          2:	connected
		nodeid:          3:	localhost
Das Entscheidende steht aber im Protokoll, weil dort die Zeit mitläuft:
2026-09-30 12:55:03+02:00 prox03 corosync[2479]:   [KNET  ] link: host: 2 link: 0 is down
2026-09-30 12:55:03+02:00 prox03 corosync[2479]:   [KNET  ] link: host: 1 link: 0 is down
2026-09-30 12:55:03+02:00 prox03 corosync[2479]:   [KNET  ] host: host: 2 (passive) best link: 1 (pri: 1)
2026-09-30 12:55:03+02:00 prox03 corosync[2479]:   [KNET  ] host: host: 1 (passive) best link: 1 (pri: 1)
2026-09-30 12:55:37+02:00 prox03 corosync[2479]:   [KNET  ] rx: host: 2 link: 0 is up
2026-09-30 12:55:37+02:00 prox03 corosync[2479]:   [KNET  ] rx: host: 1 link: 0 is up
2026-09-30 12:55:37+02:00 prox03 corosync[2479]:   [KNET  ] host: host: 2 (passive) best link: 0 (pri: 1)
2026-09-30 12:55:37+02:00 prox03 corosync[2479]:   [KNET  ] host: host: 1 (passive) best link: 0 (pri: 1)
2026-09-30 12:55:38+02:00 prox03 corosync[2479]:   [KNET  ] pmtud: Global data MTU changed to: 1397
Um 12:55:03 fällt Link 0 aus, in derselben Sekunde steht best link: 1 — die
Umschaltung passiert so schnell, dass sie in der Protokollauflösung keinen Abstand
hat. Um 12:55:37 ist die Karte zurück und Corosync wechselt von selbst wieder auf
Link 0. Dazwischen: kein Mitgliedschaftswechsel, keine Neubildung des Clusters,
keine Meldung über verlorene Knoten. Alle drei Knoten melden während des ganzen
Vorgangs Quorate: Yes.
Genau dafür war die Übung. Vorher hätte derselbe Ausfall prox03 aus dem Cluster
geworfen und auf allen drei Knoten /etc/pve schreibgeschützt.
Wenn es schiefgeht
Der unangenehme Fall: die Konfiguration ist fehlerhaft, das Cluster verliert das
Quorum, und damit ist /etc/pve schreibgeschützt — also genau das Verzeichnis,
in dem die Datei liegt, die ihr korrigieren müsstet. Das ist der Moment, in dem
man froh ist, den Weg vorher gelesen zu haben.
Der Ausweg führt über pmxcfs im lokalen Modus. Auf dem betroffenen Knoten:
systemctl stop pve-cluster corosync
pmxcfs -l
Damit ist /etc/pve wieder beschreibbar, allerdings nur lokal und ohne
Replikation. Jetzt die corosync.conf reparieren — entweder aus der Sicherung
zurückholen oder den Fehler beheben — und anschließend zurück in den
Normalbetrieb:
killall pmxcfs
systemctl start pve-cluster corosync
Deswegen die Sicherung ganz oben. Und deswegen macht man diese Änderung nicht an einem Freitagabend.
Fallstricke, die ich mir notiert habe
- Nicht auf ein Netz legen, über das große Datenmengen laufen. Auch nicht als Link 1, nach dem Motto „ist ja nur der Ersatzweg“. Wenn Link 0 ausfällt, schaltet Corosync genau in dem Moment um, in dem euer Backup läuft.
- MTU einheitlich halten. Unterschiedliche MTU auf demselben Ring ist eine Fehlerquelle, die sich als sporadischer Mitgliedschaftsverlust äußert und sich entsprechend schlecht sucht.
- Firewall: der neue Ring braucht einen eigenen Port. Das ist die Stelle, an der ich selbst falsch geraten hätte — ich hatte angenommen, beide Links nutzen dieselbe Freigabe. Tun sie nicht: Link 0 läuft auf UDP 5405, Link 1 auf UDP 5406, und so weiter nach oben. Steht im Protokoll, siehe oben. Wer die Proxmox-Firewall benutzt, muss den zweiten Port also gesondert freigeben.
- Nicht beides gleichzeitig ändern. Erst den zweiten Ring einbauen und
prüfen, dann bei Bedarf über
link_modenachdenken. Wenn hinterher etwas klemmt, wollt ihr wissen, welche der beiden Änderungen es war. - Drei Knoten bleiben drei Knoten. Ein zweiter Ring schützt den Pfad, nicht die Mehrheit. Fällt ein Knoten von drei aus, ist das Cluster weiter quorat; fallen zwei aus, hilft auch der schönste Ring nichts mehr.
Fazit
Der zweite Corosync-Ring ist eine der Maßnahmen mit dem besten Verhältnis zwischen Aufwand und Wirkung: ein paar Zeilen in einer Datei, kein Neustart, keine Ausfallzeit — und danach übersteht das Cluster den Ausfall eines Switches oder eines Kabels, ohne in den Schreibschutz zu fallen. Vorausgesetzt, der zweite Weg ist tatsächlich ein anderer Weg.
Was mich an der Sache gereizt hat, ist dass man dabei versteht, warum Proxmox sich in bestimmten Situationen so verhält, wie es sich verhält. „Das Cluster ist plötzlich read-only“ ist keine Macke, sondern die logische Folge eines Protokolls, das lieber nichts tut als etwas Falsches.
Im nächsten Teil der Serie schaue ich mir an, ob auf denselben drei Knoten ein Ceph-Cluster sinnvoll ist — die Antwort ist interessanter, als ich erwartet hatte, und sie hat weniger mit dem Netzwerk zu tun als mit Rechnen.
Wie immer: Fragen, Anregungen und Widerspruch gerne in die Kommentare oder per Mail.